从公开数据看AI推理芯片的显存带宽竞赛:三条技术路线怎么选
显存带宽正成为AI推理芯片的关键指标。本文从公开规格出发,对比HBM、GDDR与近存计算三条路线的取舍逻辑,梳理产业动态,帮读者理解带宽数字背后的真实含义。
行业资讯
2026-10-22
阅读 4416
球帝直播行业资讯栏目聚焦AI训练与推理芯片的公开产业动态,涵盖产品发布、生态进展与标准更新,由编辑团队按公开来源整理,帮助读者快速掌握智能芯片产业链的关键节点。
显存带宽正成为AI推理芯片的关键指标。本文从公开规格出发,对比HBM、GDDR与近存计算三条路线的取舍逻辑,梳理产业动态,帮读者理解带宽数字背后的真实含义。
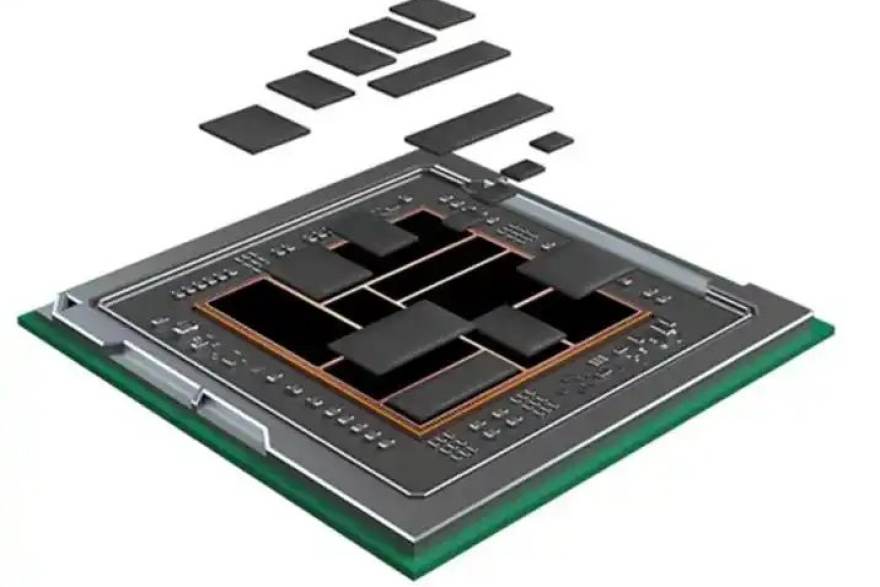
端侧AI芯片的能效评估常被简化为一串TOPS数字。本文从公开规格书出发,提出“负载匹配、内存层级、工艺与封装”三层分析框架,帮助读者理性看待端侧智能芯片的产业进展。
推理芯片的瓶颈正从算力转向显存带宽与容量。本文梳理近存计算、HBM堆叠与Chiplet封装三条公开产业路线,分析各自适用场景与落地难点,帮助读者理解智能芯片产业链的关键节点。
从训练走向推理,芯片算力不再是唯一标尺。本文梳理显存带宽与容量如何决定推理吞吐与首字延迟,并给出面向实际部署的选型观察维度,帮助读者理解智能芯片产业链的关键变化。
训练芯片的落地节奏越来越取决于软件栈成熟度。本文按公开资料整理编译器、算子库、分布式训练框架支持与调试工具四个维度的盘点方法,给出可复用的评估清单。
训练大模型时,芯片之间的连接方式往往比单卡性能更决定整体效率。本文用通俗方式解释互联拓扑、带宽收敛比与集群扩展的基本概念,帮助读者建立评估智能芯片集群方案的入门框架。
从公开产品参数与生态成熟度出发,梳理云端推理与端侧推理两条芯片路线的差异,给出按场景选型的盘点清单,帮助读者快速判断算力、带宽与功耗的取舍。
一位从大厂架构岗走向创业的芯片人,讲述推理芯片从“能跑就行”到“能效为王”的十年。他如何看待算力堆叠、显存带宽与软件生态的取舍,又如何理解当下产业分工的变化。
端侧AI芯片的能效数字常被简化成一句"每瓦多少算力"。本文从公开资料出发,拆解能效指标的统计口径、场景差异与生态影响,帮助读者建立更可靠的阅读方法。
流片前的验证工作很少被讨论,却直接决定芯片能否按时点亮。一位从事推理芯片验证的工程师讲述回归测试、覆盖率与跨团队协作的真实状态,也谈她对产业节奏的理解。